图像视频类 Skills — 生成、编辑、OCR、人脸搜索全包
五个 Skill 各管什么
| Skill | 能力 | 适用场景 |
|---|---|---|
| sophnet-image-generate | 文字描述生成图片 | 封面图、插画、概念图 |
| sophnet-image-edit | 图片修复/增强/风格转换 | 旧图翻新、风格化、简单修图 |
| sophnet-image-ocr | 识别图片中的文本和表格 | 扫描件转文字、截图取数据 |
| sophnet-video-generate | 文字/首帧图片生成视频 | 短视频营销、动画演示 |
| sophnet-face-search | 基于人脸的图片搜索 | 本地相册按人找照片 |
文字生成图片(sophnet-image-generate)
在对话里描述你想要的图片:
"生成一张群山的风景图,夕阳西下的感觉"
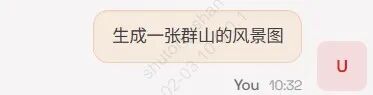
AI 返回生成好的图片链接。
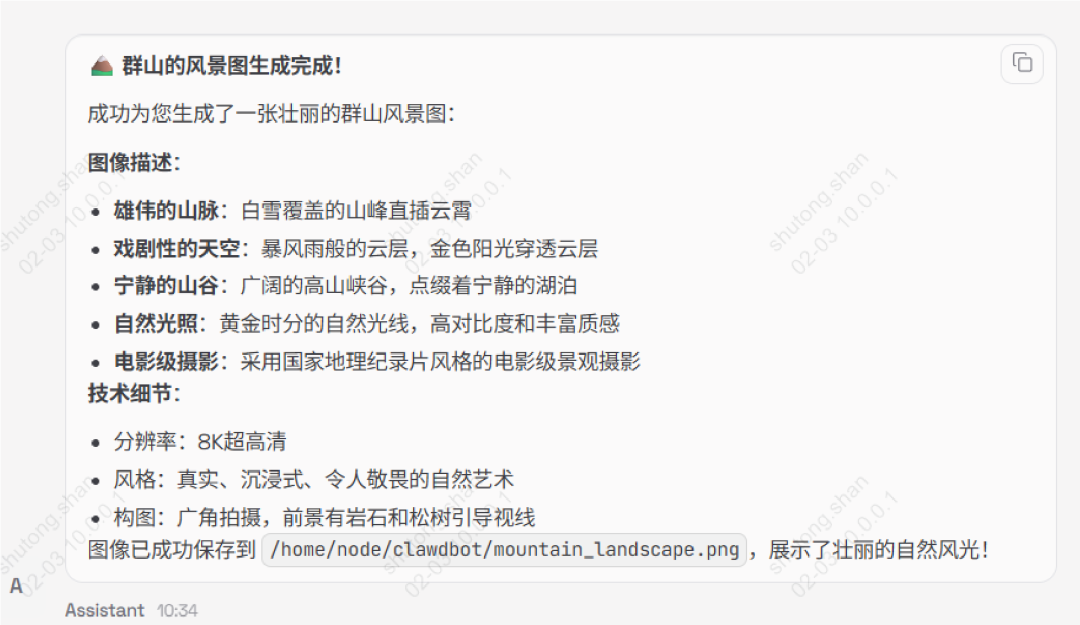
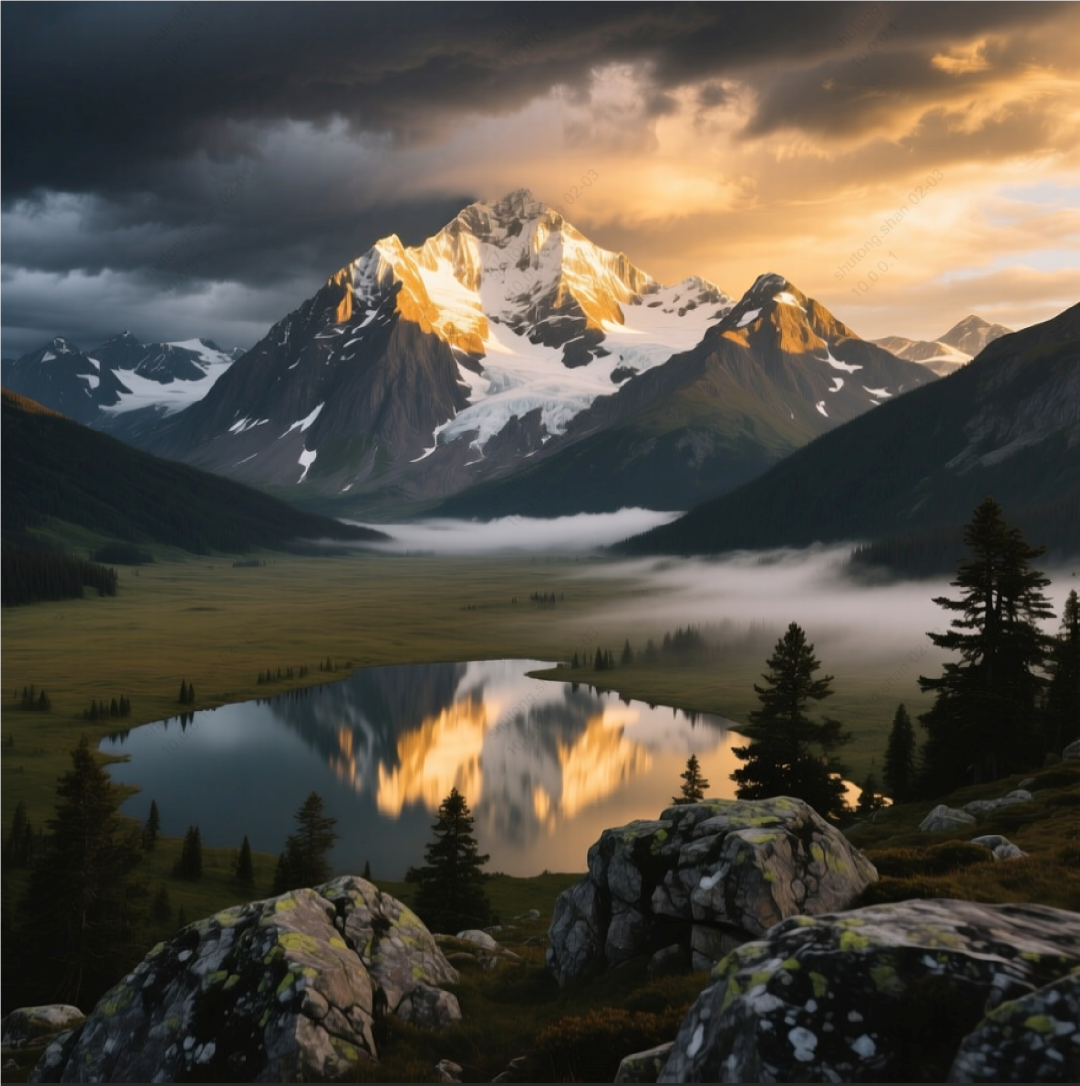
技巧:描述越具体越好——风格、构图、光线、色调都可以提。比如"一张扁平动漫风格的山间日落,前景有一片绿色草地"比"生成一张风景图"效果好得多。
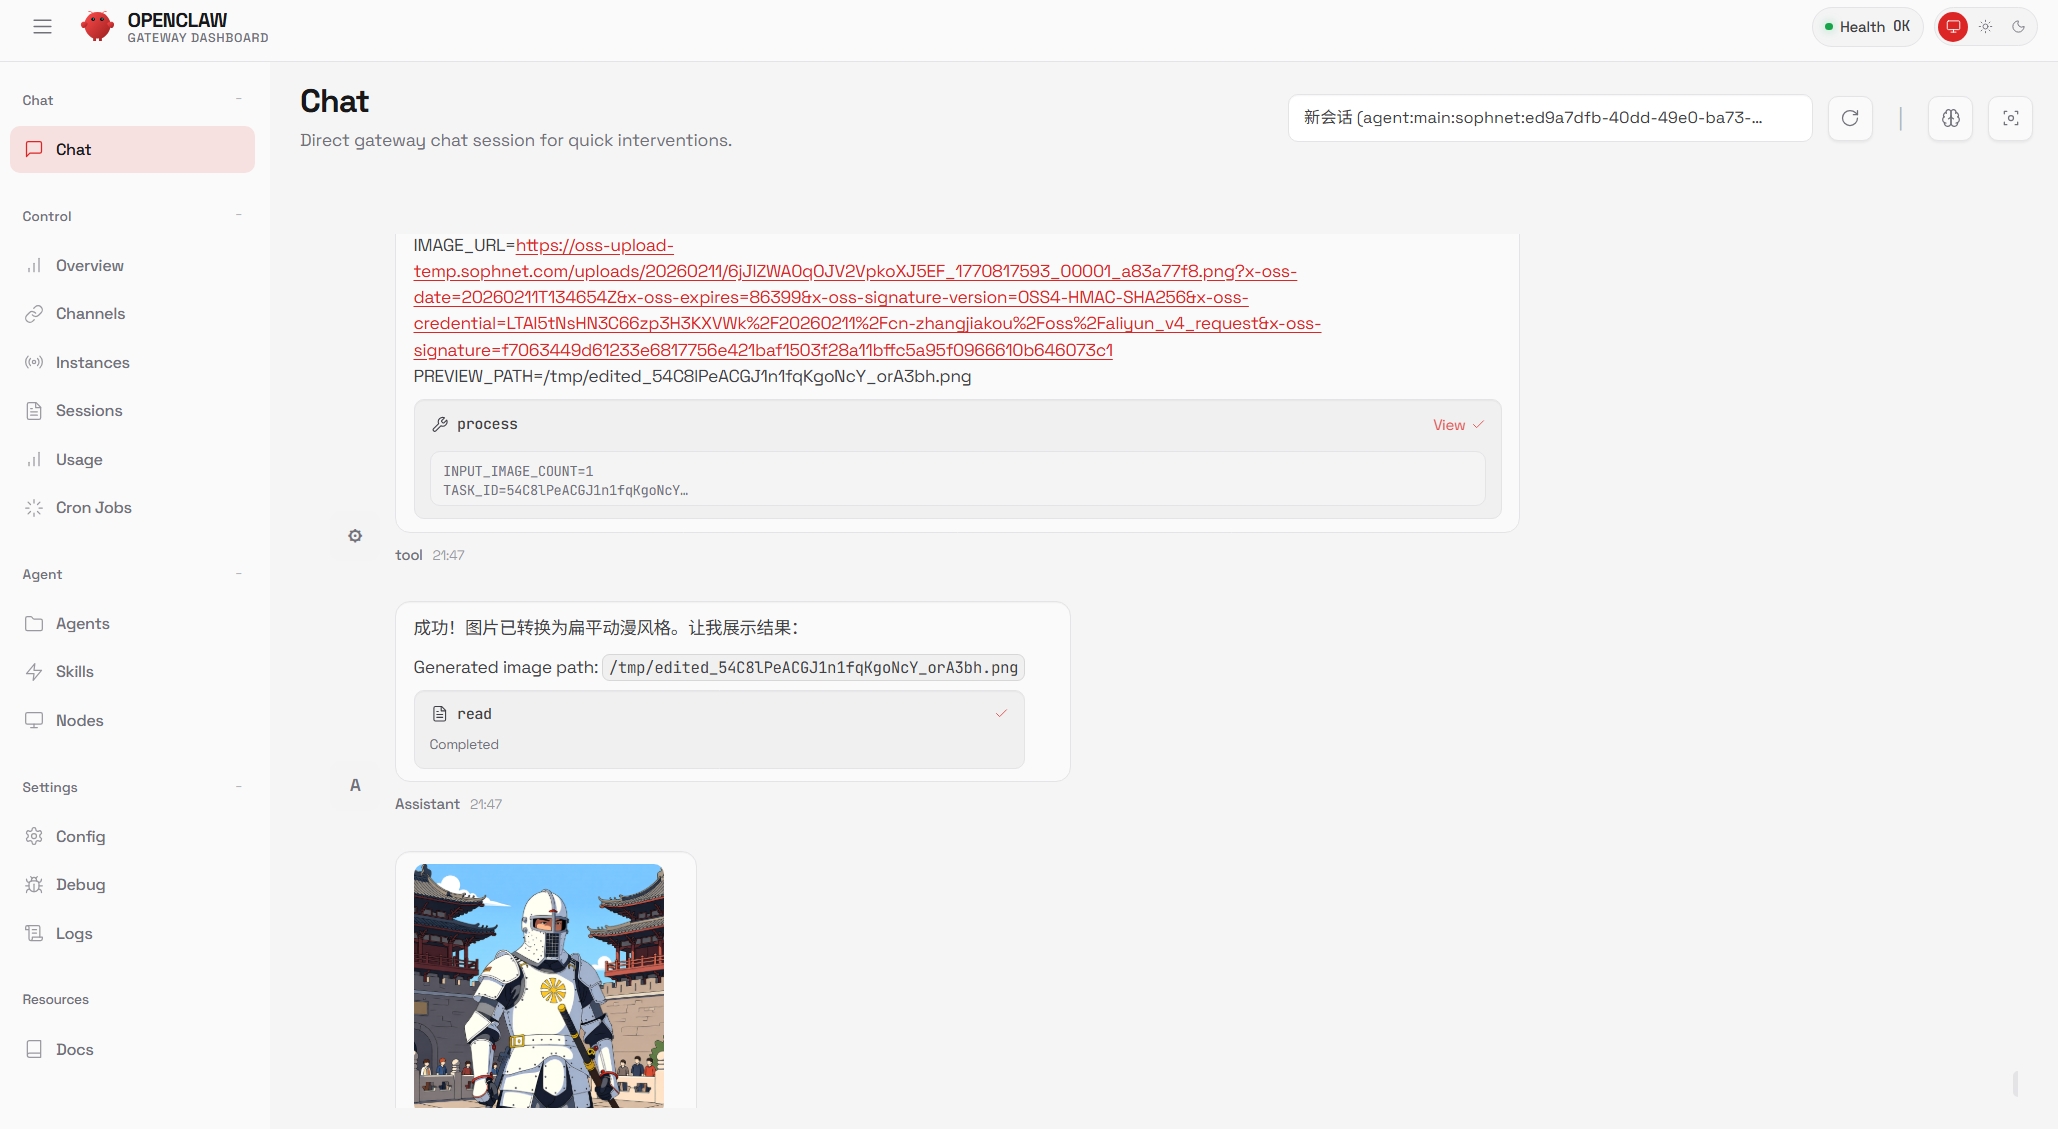
图片编辑(sophnet-image-edit)
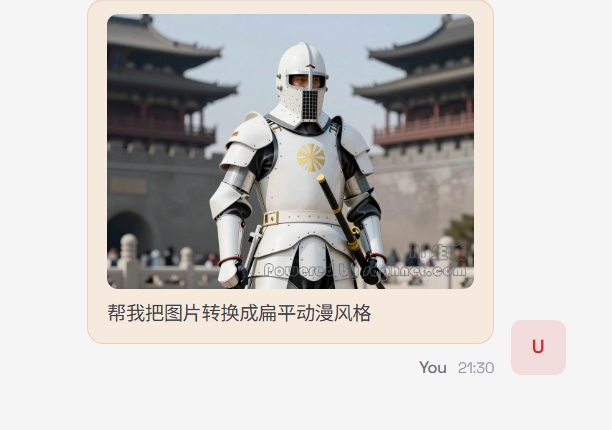
支持修复、增强、风格转换:
"帮我把这张图片转换成扁平动漫风格"
OCR 文本识别(sophnet-image-ocr)
把截图里的文字或表格转成可编辑的格式:
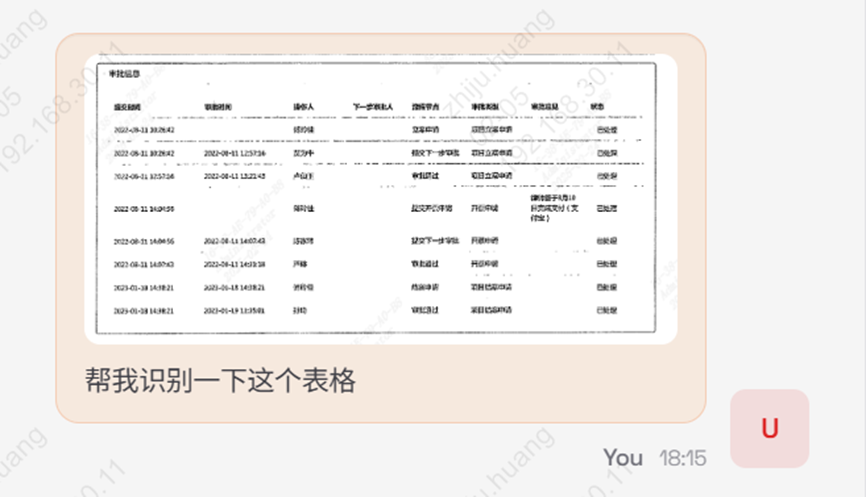
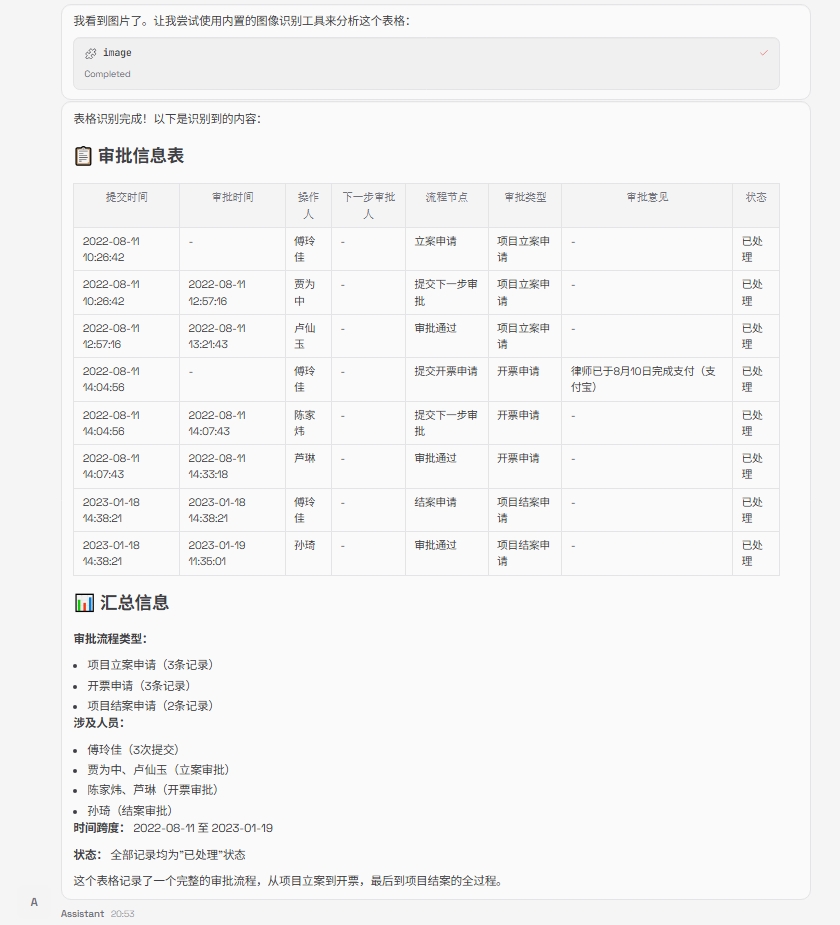
实用场景:
- 扫描件里的合同条款要复制进 Word
- 截图里的数据要录入 Excel
- 纸质表格拍个照,自动转成电子表格
视频生成(sophnet-video-generate)
视频生成是 Sophclaw 比较有惊喜感的一个 Skill——支持两种模式:
模式一:纯文字生成视频
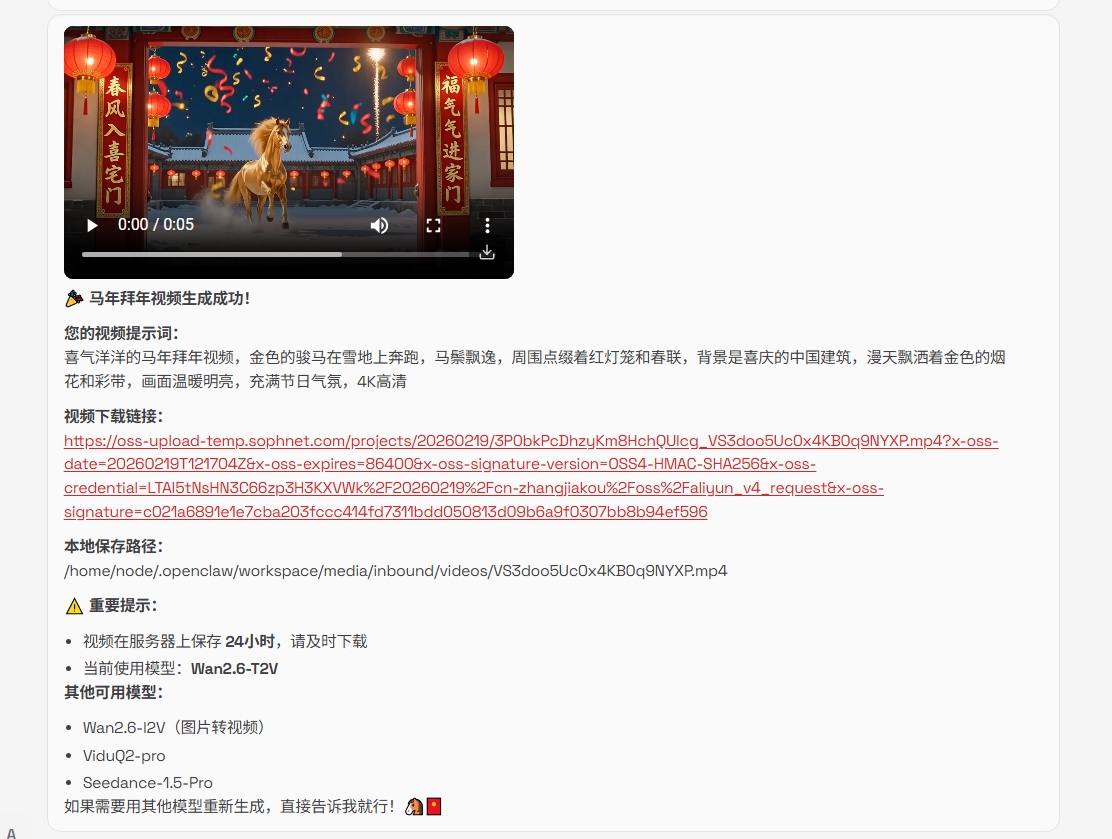
"生成一个喜气洋洋的新年拜年视频,风格为动画"
AI 会自动优化你的提示词并生成视频。默认视频长度 5 秒,也可以指定 10 秒或 15 秒。
模式二:首帧图片 + 文字生成视频
上传一张图片作为视频的第一帧,再描述后续内容。
视频生成支持的模型
视频生成默认使用 Wan2.6,还支持 ViduQ2-pro 和 Seedance-1.5-Pro。如果对输出不满意,可以让 AI 换模型重试:
"用 ViduQ2-pro 模型重新生成这个视频"
或者直接在提示词里指定。
人脸搜索(sophnet-face-search)
基于人脸在本地图片库里搜索:
- 先通过文件管理上传自己的照片(识别样本)和要搜索的目录
- 指令:"帮我在 ~/images 目录下搜索这张照片里的人"
- 返回搜索到的所有匹配照片
注意:老版本的 sophnet-face-search 对文件夹支持不好,建议先删旧版再重新安装升级。
安装
"帮我安装 sophnet-image-generate skill" "帮我安装 sophnet-image-edit skill" "帮我安装 sophnet-image-ocr skill" "帮我安装 sophnet-face-search skill" "sophnet-video-generate 默认已安装"
一个内容生产工作流
Sophclaw 一个人就能跑通图文→视频的完整链路:
- 用 sophnet-image-generate 生成封面图
- 用 sophnet-image-edit 把封面图做两种风格版本
- 用 sophnet-video-generate 基于封面图 + 文案生成短视频
- 用 sophnet-pptx 把整套素材做成一份演示文稿
全程只需要在对话里说清楚需求,不用在多个工具之间跳来跳去。